Woven vs Lemonsignal:並べて比較
Wovenが自社サイトに記載している内容(2026年10月28日確認)とLemonsignalの比較。
|  | |
|---|
| 候補者が行うこと | エンジニアリング業務を模した短い時間制限付きシナリオ:コードレビュー、本番環境のバグのデバッグ、プログラミング、システム設計。AIなし、AIファースト、その組み合わせを選べます | バグの修正やキャンペーンの計画など、実際の業務から作ったタスク |
| 使うAIツール | 候補者自身のもの:「Bring-Your-Own LLM」。AIファーストのシナリオの例として、Copilot Agent Mode、Cursor、エージェント型IDEが同社のページに挙げられています | 候補者自身のツール:Claude Code、Codex、Claude Cowork、ChatGPTを、自分のパソコンまたはブラウザで |
| 採点する人 | 人:「double-blind scoring by two certified engineers」。AIを使うシナリオでは、トップモデルが一度に生成するものと成果物を比較し、候補者が加えた価値を採点します | Lemonsignalが、誰かがタスクに取り組む前に作成した採点シートに沿って一次評価を行います。チームがセッションを見て、一次評価を確認し、判断します |
| 職種 | エンジニアリング:フルスタック、フロントエンド、バックエンド、SRE、DevOps、エンジニアリングマネージャー、データサイエンス | エンジニアリング、プロダクト、デザイン、マーケティング、データ、財務 |
| 不正の確認 | すべてのアセスメントでAIと盗用を検知。AIなしのシナリオでは人による非同期の試験監視 | タスクに取り組んでいるのが送付先の本人であること、成果物と会話が一致していることを確認します |
| 受け取れるもの | 候補者ごとの強みと弱みのレポート。候補者も自分の成果物について技術的なフィードバックを受け取れます | 推薦の判定、6つのAIスキル、職務スキル2〜3個。それぞれが根拠となった会話の場面にリンクしています |
Woven vs Lemonsignal:採用チームが受け取るもの
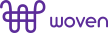
WovenWovenの結果:各候補者のスコアをチームのレベル別基準に照らして表示します。画像はwoventeams.comより(2026年10月28日)。 Lemonsignal。Claude Codeで実際のバグを修正したエンジニアの結果です。すべてのスコアが、根拠となった会話の場面にリンクしています。
LemonsignalDana Okafor
89%高い適合
- AIに修正を書かせる前に原因を突き止めました。
- AIの修正をうのみにせず、テストしました。
- 最初のサービス用に作ったもので、2つ目のサービスも修正しました。
- 理解する 優秀 AIに二重請求を再現させ、修正に入る前に1件の決済をコード上で追いました。 ターン2
- 指示する 十分 ログと重要なファイルを渡し、変更してはいけない箇所を伝えました。 ターン4
- 確認する 優秀 AIの最初の修正にテストを実行して却下しました。自分の修正はテストで証明しました。 ターン12、19
- 修正する 優秀 最初の修正がなぜ間違いなのか、どこを見るべきかをAIに伝えました。 ターン13
- 承認する 十分 小さな変更とそのテスト、テストしていない点のメモを提出しました。
- 再利用する 優秀 手順をskillとして保存し、それを使って返金サービスを修正しました。
職務に必要なスキル - 根本原因の特定基準以上
- テストによる修正の証明基準以上
- 他の人が保守できるコード基準どおり
提出されたままの成果物です。各マークは結果に示されたスキルに対応しています。
理解する優秀承認する十分 変更メモ ゲートウェイが再試行しても、注文ごとの請求は1回に - 原因:ゲートウェイのタイムアウト後、再試行で2回目の請求が発生していました。
- 修正:各請求に注文ごとのキーを持たせ、再試行時は新しい請求を作らず最初の請求を返します。
- テスト:タイムアウト後の再試行でも請求は1回になりました。48件のテストがすべて成功しています。
- 未テスト:一部請求(現在は未使用)。
確認する優秀再利用する優秀 payments/charge.py修正
def create_charge(order, card):
- return gateway.charge(order.total, card)
+ key = f"order-{order.id}"
+ return gateway.charge(order.total, card,
+ idempotency_key=key)
tests/test_charge.py修正前は失敗し、修正後は成功
+def test_retry_charges_once(gw, order, card):
+ gw.fail_next_with(Timeout)
+ create_charge(order, card)
+ create_charge(order, card) # the retry
+ assert gw.charges_for(order) == 1
refunds/refund.py返金サービスへの同じ修正
def create_refund(charge, amount):
- return gateway.refund(charge.id, amount)
+ key = f"refund-{charge.id}"
+ return gateway.refund(charge.id, amount,
+ idempotency_key=key)
WovenとLemonsignal、どちらを選ぶべきですか?
Wovenが合うのはこんな場合 - エンジニアだけを採用し、すべての候補者を2名のエンジニアに採点してほしい。
- 短いシナリオで、AIなしとAIファーストのタスクを組み合わせたい。
- 候補者に詳しい技術的なフィードバックを渡したい。
Lemonsignalが合うのはこんな場合 - プロダクト、デザイン、マーケティング、データ、財務など、エンジニア以外も採用する。
- AIとの会話全体をセッションリプレイとして記録したい。
- すべてのスコアを、根拠となった会話の場面に結びつけたい。
出典:Wovenホームページ · Woven AI-enabled technical assessments。WovenとそのロゴはWovenに帰属します。画像は同社のサイトからのもので、プロダクトの比較のために掲載しています。プロダクトは変わります。古い情報があればお知らせください。
Woven vs Lemonsignal:よくある質問
LemonsignalはWovenとどう違いますか?
両者は近いものです。どちらも候補者が自分のAIを使えます。Wovenはエンジニア向けで、短いシナリオを2名のエンジニアが採点します。Lemonsignalはエンジニア以外の職種にも対応し、AIとの会話全体を記録して、すべてのスコアを該当の場面に結びつけます。
LemonsignalでもWovenのように候補者が自分のAIツールを使えますか?
はい。Claude Code、Codex、Claude Cowork、ChatGPTを、自分のパソコンまたはブラウザで使えます。