L’alternativa a Woven per testare le competenze AI.
Woven offre scenari di ingegneria, come una code review o un bug in produzione, valutati da due ingegneri certificati, e lascia ai candidati il proprio modello AI. Lemonsignal dà un compito reale anche a ruoli oltre l’ingegneria, registra l’intera conversazione con l’AI e dà al suo team una prima lettura da controllare.
Woven vs Lemonsignal: confronto affiancato
Ciò che Woven dice sul proprio sito, verificato il 28 ott 2026, accanto a Lemonsignal.
Che cosa fanno i candidati
Scenari brevi a tempo che simulano il lavoro di ingegneria: code review, debug di un bug in produzione, programmazione e progettazione di sistemi. Lei sceglie senza AI, AI-first o un mix
Un compito reale del ruolo, come un bug da correggere o una campagna da pianificare
Quale strumento AI
Il proprio: “Bring-Your-Own LLM”. La loro pagina cita Copilot Agent Mode, Cursor e IDE agentici come esempi per gli scenari AI-first
Il proprio: Claude Code, Codex, Claude Cowork o ChatGPT, sul proprio computer o nel browser
Chi valuta
Persone: “double-blind scoring by two certified engineers”. Negli scenari con AI, il lavoro è confrontato con ciò che un modello di punta produce in un colpo solo e viene valutato ciò che il candidato aggiunge
Lemonsignal dà una prima lettura, in base a una griglia di valutazione scritta prima che qualcuno svolga il compito. Il suo team guarda la sessione, controlla la lettura e decide
Ruoli
Ingegneria: full-stack, frontend, backend, SRE e DevOps, engineering manager e data science
Ingegneria, prodotto, design, marketing, data e finanza
Controllo contro gli imbrogli
Rilevamento di AI e plagio in ogni valutazione e sorveglianza umana asincrona per gli scenari senza AI
Verifica che chi svolge il compito sia la persona a cui l’ha inviato e che il lavoro corrisponda alla conversazione
Che cosa riceve
Un report su punti di forza e debolezze per ogni candidato; anche i candidati ricevono un feedback tecnico sul loro lavoro
Una raccomandazione, sei competenze AI e due o tre competenze del ruolo, ciascuna collegata al momento della conversazione da cui proviene
Woven vs Lemonsignal: che cosa riceve il team di selezione
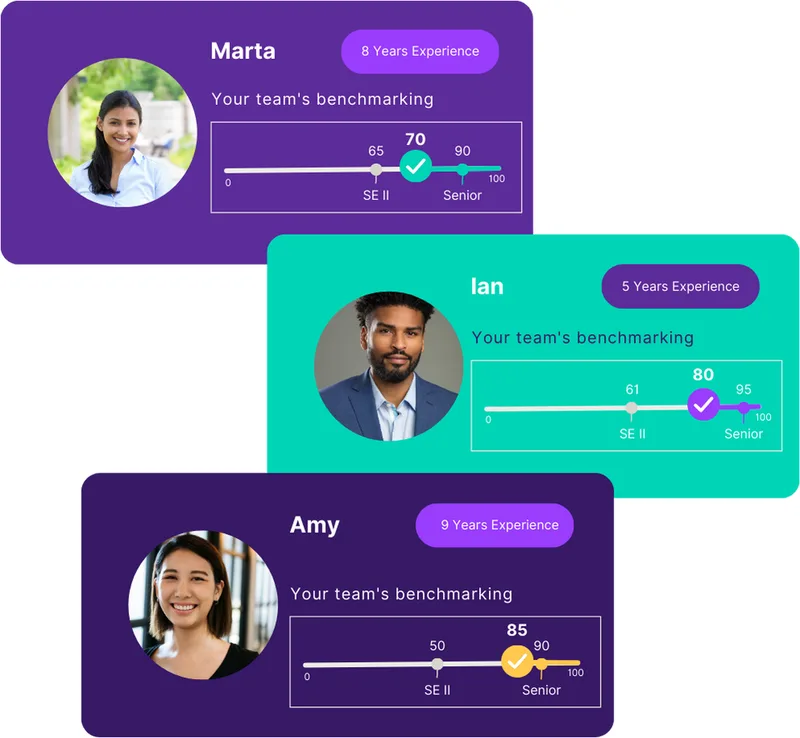
WovenRisultati Woven: il punteggio di ogni candidato rispetto ai riferimenti del suo team per livello. Immagine da woventeams.com, 28 ott 2026.
Lemonsignal. Il risultato di un’ingegnera che ha corretto un bug reale con Claude Code. Ogni punteggio rimanda al momento della conversazione da cui proviene.
LemonsignalDana Okafor
Dana OkaforBackend engineer · Compito: correggere un doppio addebito · Claude Code · 2 h 40 min
Verificato da Lemonsignal
89%Forte corrispondenza
Ha trovato la causa prima di lasciare che l’AI scrivesse una correzione.
Ha testato la correzione dell’AI invece di fidarsi.
Ha corretto il secondo servizio con ciò che aveva costruito per il primo.
CapireForteLe ha fatto riprodurre il doppio addebito e ha seguito un pagamento nel codice prima di qualsiasi correzione.Turno 2
Dare il briefSolidoLe ha dato i log e i file che contano, e ha detto che cosa non doveva cambiare.Turno 4
VerificareForteHa eseguito i test sulla prima correzione dell’AI e l’ha respinta. Ha dimostrato la propria correzione con un test.Turni 12, 19
CorreggereForteLe ha spiegato perché la prima correzione era sbagliata e dove cercare invece.Turno 13
ApprovareSolidoUna piccola modifica con il suo test e una nota su ciò che non ha testato.
RiutilizzareForteHa salvato i passaggi come skill e l’ha usata per correggere il servizio dei rimborsi.
Competenze per il ruolo
Trovare la causa principaleSopra la soglia
Dimostrare una correzione con un testSopra la soglia
Codice che altri possono mantenereAlla soglia
Che cosa ha consegnato, così come l’ha consegnato. Ogni segno è una competenza del suo risultato.
CapireForteApprovareSolido
Nota di modificaUn solo addebito per ordine, anche se il gateway riprova
Causa: dopo un timeout del gateway, il nuovo tentativo creava un secondo addebito.
Correzione: ogni addebito porta una chiave del suo ordine, così un nuovo tentativo restituisce il primo addebito invece di crearne uno nuovo.
Test: un nuovo tentativo dopo un timeout ora addebita una sola volta. Tutti i 48 test passano.
Non testato: le catture parziali, che non usiamo ancora.
VerificareForteRiutilizzareForte
payments/charge.pyLa correzione
def create_charge(order, card):
- return gateway.charge(order.total, card)
+ key = f"order-{order.id}"
+ return gateway.charge(order.total, card,
+ idempotency_key=key)
tests/test_charge.pyFallisce prima della correzione, passa dopo
+def test_retry_charges_once(gw, order, card):
+ gw.fail_next_with(Timeout)
+ create_charge(order, card)
+ create_charge(order, card) # the retry
+ assert gw.charges_for(order) == 1
refunds/refund.pyLa stessa correzione nel servizio dei rimborsi
def create_refund(charge, amount):
- return gateway.refund(charge.id, amount)
+ key = f"refund-{charge.id}"
+ return gateway.refund(charge.id, amount,
+ idempotency_key=key)
Scegliere Woven o Lemonsignal?
Scelga Woven se
Assume solo ingegneri e vuole che due ingegneri valutino ogni candidato.
Vuole scenari brevi e un mix di compiti senza AI e AI-first.
Vuole che i candidati ricevano un feedback tecnico dettagliato.
Scelga Lemonsignal se
Assume anche fuori dall’ingegneria: prodotto, design, marketing, data o finanza.
Vuole l’intera conversazione con l’AI registrata, come replay della sessione.
Vuole ogni punteggio collegato al momento della conversazione da cui proviene.
Sono vicini: entrambi lasciano ai candidati la propria AI. Woven è per ingegneri, con scenari brevi valutati da due ingegneri. Lemonsignal copre ruoli oltre l’ingegneria, registra l’intera conversazione con l’AI e collega ogni punteggio al suo momento.
Lemonsignal lascia ai candidati il proprio strumento AI, come Woven?
Sì: Claude Code, Codex, Claude Cowork o ChatGPT, sul proprio computer o nel browser.